

Van dashboards die je leest naar een systeem waar je tegen praat.
Plainsight maakt data platforms klaar voor Generative BI: je gaat steeds vaker vragen stellen in gewone taal in plaats van een dashboard te lezen, maar of het antwoord klopt, hangt af van het semantic model eronder, niet van de agent erbovenop.
Van dashboards naar dialoog
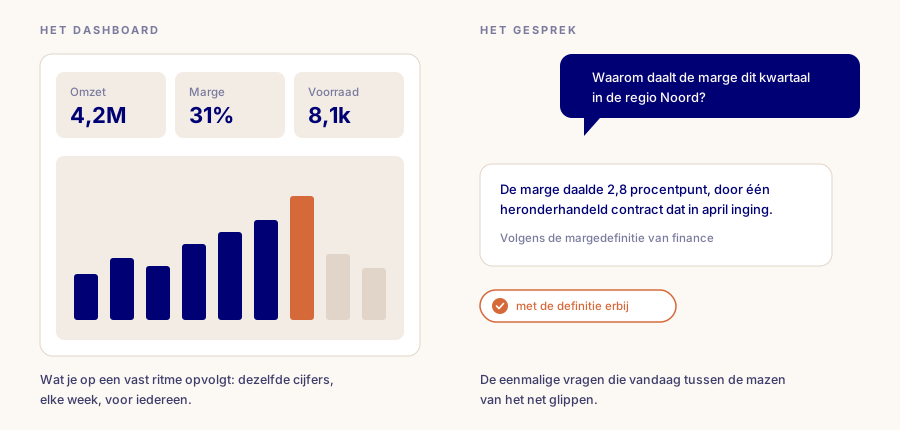
Twintig jaar lang was het dashboard het eindpunt. Het werkte, maar het was traag, het verouderde, en het beantwoordde alleen de vragen waar iemand op voorhand aan gedacht had.
Het dashboard verdwijnt niet. Het blijft voor wat je op een vast ritme opvolgt. Wat het gesprek toevoegt, is de long tail: de eenmalige vragen die nooit een rapport waard waren en vandaag als ticket bij het datateam belanden, of nooit gesteld worden.
VOOR WE BEGINNEN
Klinkt dit bekend?
De problemen waar mensen mee bij ons komen, nog voor iemand een vraag aan de data stelt. Elk ervan heeft een uitweg, en de rest van deze pagina is hoe we er geraken.
Hoe we het aanpakken
Één cijfer week af van wat de raad van bestuur te zien kreeg, niemand kon uitleggen waarom, en mensen stopten stilletjes met vragen stellen.
Hoe we het aanpakken
Dat antwoord staat in geen enkele tabel. Het zit in hoe elk rapport zijn datums definieert, of in welke klanten een van de twee meetelt.
Hoe we het aanpakken
Een agent erft die dubbelzinnigheid en antwoordt toch zelfzeker, met iemands definitie, alleen niet noodzakelijk de jouwe.
Hoe we het aanpakken
Een tabel veranderde, een metric werd verfijnd, de context volgde niet. De antwoorden gaan niet stuk. Ze worden subtiel fout.
Hoe we het aanpakken
Dat instinct klopt. Beter dat je weet welke gaten er zijn voor je de business een chatbot belooft.
Waarom data moeilijker is dan software
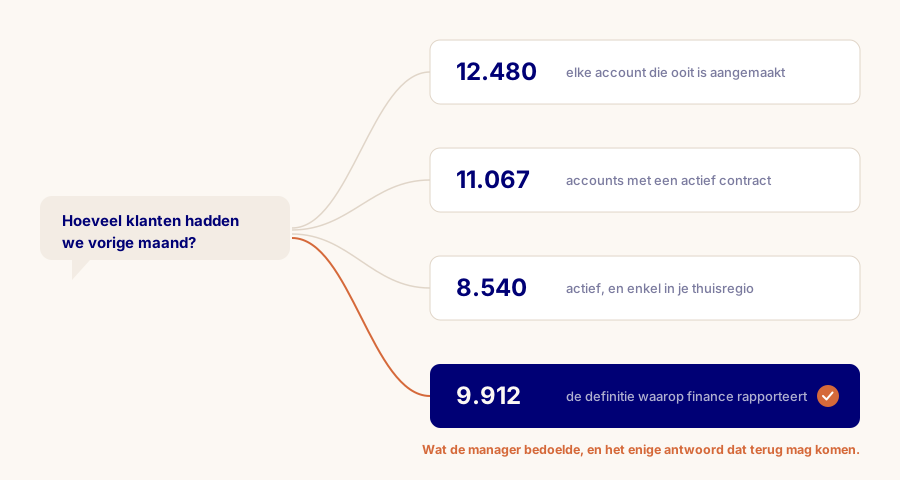
Bij software leiden meerdere wegen naar een correcte oplossing, en tests vangen een fout resultaat snel op. Data werkt anders. Vraag hoeveel klanten je vorige maand had, en het antwoord verschuift met de filters en de invalshoek die je kiest. Een fout antwoord ziet er even overtuigend uit als een juist antwoord. De uitdaging is dus niet de query uitvoeren. Het gaat erom of de agent een vraag in gewone taal kan koppelen aan de juiste, actuele plek in je model.
vragen correct beantwoord als je een frontier AI-model loslaat op een ruw enterprise data warehouse, zonder beschreven model om op te steunen.
Spider 2.0-benchmark, ICLR 2025. Een momentopname: modellen worden beter, de kloof met grounded set-ups blijft.

Wat er verandert, in drie delen
Voor eindgebruikers
BI is niet langer een dashboard dat je leest, maar een systeem waar je tegen praat.
Voor datateams
Het sleurwerk van pipelines en tickets maakt plaats voor agents die een eerste versie maken, testen en herstellen.
Bouwstenen
Wat dit alles betrouwbaar maakt, inclusief de governance waardoor een agent kan zeggen dat hij het niet weet.
Het semantic model, en de betekenis erboven
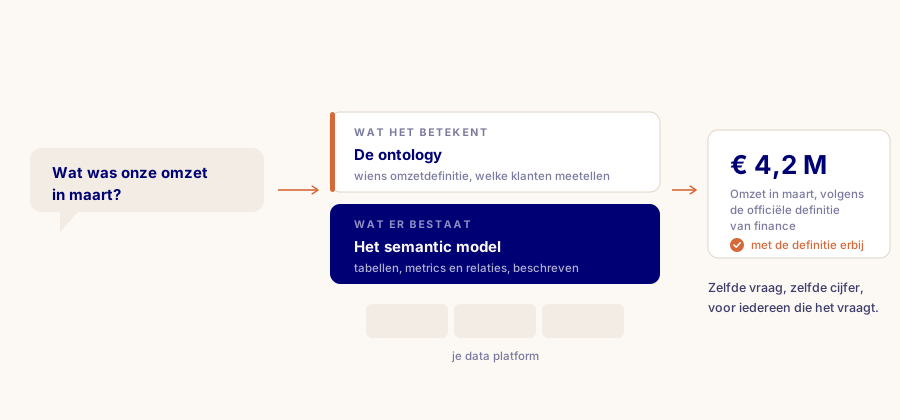
Het semantic model zegt wat er bestaat. De ontology zegt wat het betekent.
Het begint met een sterk semantic model: de laag waarin je je tabellen, metrics en relaties beschrijft, zodat de agent weet waarvoor elk ervan dient. Als een vraag aansluit op een gedefinieerde metric, krijgt iedereen in het bedrijf hetzelfde cijfer.
Wat dat niet vat, is betekenis. Waarom omzet op een bepaalde manier berekend wordt, welke klanten meetellen, wat een begrip betekent voor het ene team tegenover het andere. Dat zit in een ontology: een gestructureerde kaart van wat de begrippen in je bedrijf betekenen en hoe alles samenhangt.
Twee dingen houden het betrouwbaar. Het moet actueel blijven, want zodra een definitie verandert en de context niet volgt, worden antwoorden subtiel fout. En elke definitie die ertoe doet, heeft een menselijke eigenaar nodig. AI maakt een eerste versie van die laag. Het mag niet beslissen wat waar is.
Je hoeft niet alles van nul te bouwen. Microsoft en Databricks bouwen ontology- en contextmogelijkheden in hun platformen.
van de vragen correct beantwoord als dezelfde AI steunt op een goed beschreven semantic layer, tegenover midden de tachtig procent zonder.
Benchmark van dbt Labs voor de semantic layer, 2026: 98 tot 100% met een beheerde semantic layer, tegenover 84 tot 90% zonder.
Waarom dit bij de meeste bedrijven misloopt
Het is zelden de technologie die het laat afweten. Dezelfde vijf patronen komen telkens terug, en elk ervan is goedkoper om te vermijden dan om te herstellen.
van de GenAI-pilots in grote bedrijven toont geen meetbare impact op het bedrijfsresultaat. Wat ontbreekt, is zelden het model. Het is het fundament eronder.
MIT Project NANDA, The GenAI Divide: State of AI in Business, 2025.
Eerst de demo. Het fundament volgt nooit.
Een chatinterface op het warehouse overtuigt in week één. Dan vraagt finance waarom de omzet van de agent afwijkt van het cijfer voor de raad van bestuur, en niemand kan het uitleggen. Het loopt niet spectaculair mis. Het krijgt gewoon nooit een echte beslissing toevertrouwd.
De context veroudert.
Definities worden één keer opgeschreven. Dan verandert er een tabel en de context volgt niet. Anthropic meldde dat hun eigen nauwkeurigheid op één maand tijd wegzakte van ongeveer 95% naar zo'n 65%. Niemand had onderhoud ingepland.
Hetzelfde woord betekent drie dingen.
Sales telt klanten op de ene manier, finance op een andere, operations op een derde. De agent erft die dubbelzinnigheid en antwoordt toch zelfzeker, met iemands definitie, alleen niet noodzakelijk de jouwe.
Niemand is eigenaar van de definities.
AI kan een eerste versie maken van wat je begrippen betekenen. Wat het niet kan, is beslissen wat officieel is, dus blijven er drie versies van marge naast elkaar bestaan. Iemand moet de knoop doorhakken, en dat moet in zijn of haar takenpakket zitten.
De agent krijgt vragen die je analisten niet kunnen beantwoorden.
Als je eigen analisten een vraag vandaag niet kunnen beantwoorden, kan een agent dat ook niet. Wat hij echt doet, is het gesprek afdwingen dat de meeste bedrijven blijven uitstellen.
Hoe we werken
Vier stappen, opgezet om alle vijf die patronen te vermijden: robuuste semantic models, definities die door mensen bewaakt worden en de datakwaliteit eronder, gebouwd samen met je mensen in plaats van over hun hoofden heen.
Welke beslissingen het zwaarst wegen, welke cijfers in vergaderingen in vraag gesteld worden, waar dashboards vandaag van elkaar verschillen. Dat vertelt ons welk domein we als eerste klaarmaken voor AI.
Een organisatieproject, geen IT-project
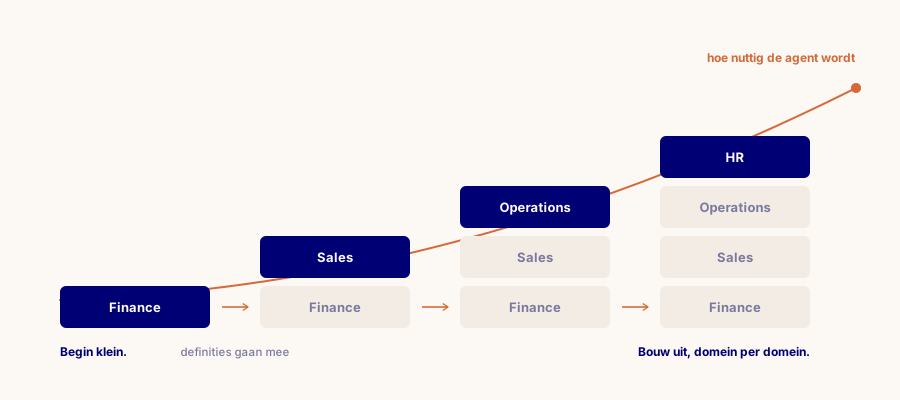
Businesstermen groeien in de loop der jaren binnen een bedrijf, en betekenen vaak iets anders voor verschillende teams. Als je chatten met je data opzet, komt dat allemaal naar boven. Dat is een voordeel, geen last: de afstemming die je voor de agent doet, is afstemming die je mensen sowieso nodig hadden. Je hoeft het niet in één keer perfect te krijgen. Begin waar de vragen het vaakst komen en de beslissingen het zwaarst wegen, en bouw van daaruit verder.
Een organisatie die het eens is over wat haar cijfers betekenen, neemt betere beslissingen, met of zonder AI.
Veelgestelde vragen
Verdwijnen dashboards?
Nee. Het dashboard blijft voor wat je op een vast ritme opvolgt. Wat verandert, is dat de eenmalige vragen, waarvoor een rapport bouwen nooit de moeite loonde, door een gesprek worden opgevangen in plaats van als ticket bij het datateam te belanden.
Kunnen we niet gewoon een data agent op ons data warehouse aansluiten?
Dat kan, en in een demo ziet het er goed uit. Losgelaten op een ruw enterprise warehouse, zonder beschreven model om op te steunen, beantwoordde een frontier AI-model in de Spider 2.0-benchmark ongeveer één vraag op vijf correct. Het verschil zit niet in de agent. Het zit in hoe goed het platform eronder daarop voorbereid was.
Wat is het verschil tussen een semantic model en een ontology?
Het semantic model zegt wat er bestaat: welke tabellen en metrics er zijn en hoe ze samenhangen. De ontology zegt wat ze betekenen: wiens definitie van omzet geldt, welke klanten meetellen. Een agent heeft ze allebei nodig. Het eerste vertelt hem waar hij moet zoeken, het tweede hoe hij moet lezen wat hij vindt.
Hoe lang duurt het voor we vragen kunnen stellen aan onze data?
Eerder dan een herbouw van je platform, later dan een demo doet vermoeden. We beginnen met één domein, meestal daar waar de vragen het vaakst komen en de beslissingen het zwaarst wegen. Elk domein dat je op punt zet, maakt het volgende sneller, omdat de definities meegaan.
Hebben we daar Microsoft Fabric of Databricks voor nodig?
Je hebt een platform nodig met een semantic layer die je kan beschrijven en beheren, en ze komen allebei in aanmerking. Microsoft en Databricks bouwen ontology- en contextmogelijkheden in hun producten, dus voor een deel van die laag kan je op je platform steunen. Plainsight is partner van allebei en werkt op Fabric, Databricks of een mix.
En als onze datakwaliteit nog niet goed genoeg is?
Dan is dat het werk, en dat weet je beter nu dan nadat je de business een chatbot beloofd hebt. Een handige test: als je eigen analisten een vraag vandaag niet kunnen beantwoorden, omdat de data ontbreekt of niemand erop vertrouwt, dan kan een agent dat ook niet.
Alles hangt samen.
Strategie geeft richting. Bouwen levert waarde op. Specialisten houden ze overeind.
Strategie
Van zakelijke vragen naar een richting voor data, AI en software die je organisatie kan volgen.
Bekijken →Bouwen
Data en analytics, AI en software op maat. Gebouwd met adoptie en eigenaarschap vanaf dag één.
Bekijken →Experts
Specialisten die meedenken als teamgenoten. Ze houden je motor draaiend en je team scherp.
Bekijken →Waar gaat jouw BI naartoe?
Als van dashboards naar dialoog de richting is die je uit wil, dan moeten we eens samenzitten. Geen pitch, gewoon een gesprek over waar je BI naartoe gaat.
Spreek een expert